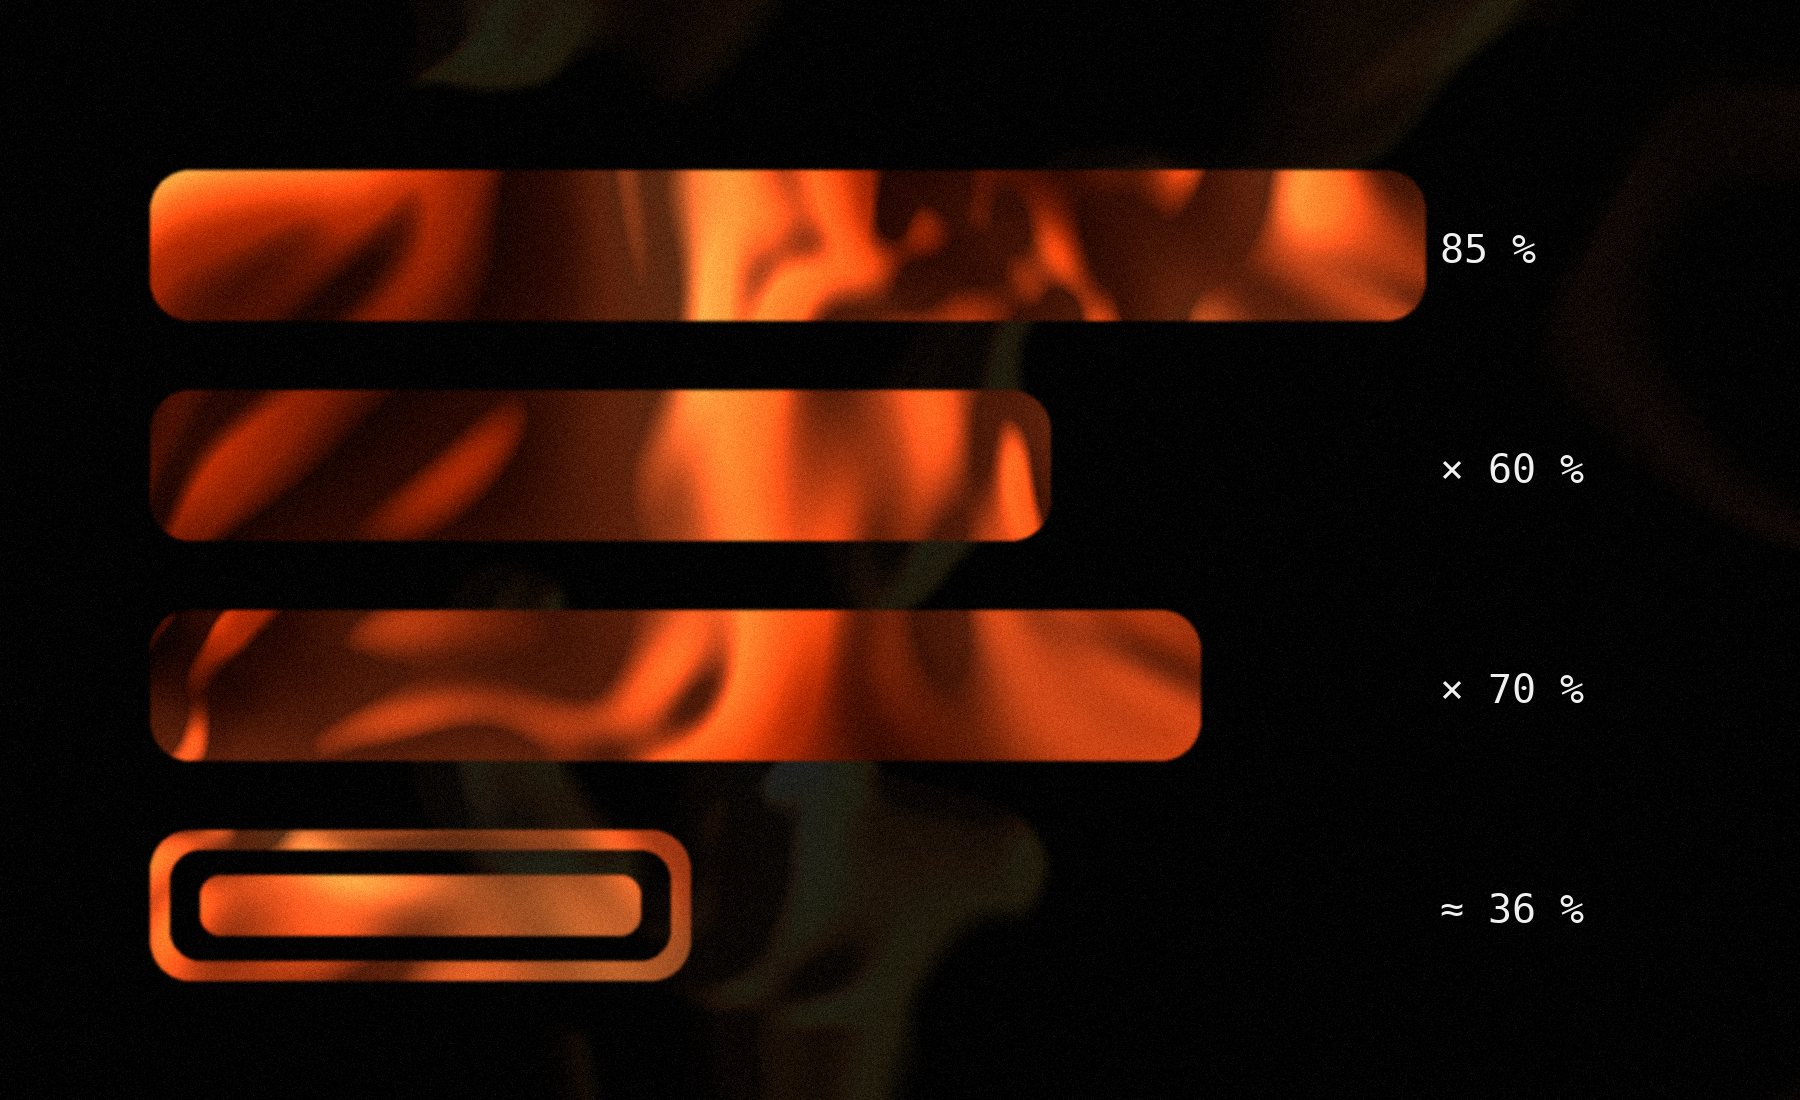
„85% schneller beim Coding“ - solche Zahlen hört man oft. Sie beschreiben einzelne Aufgaben. Was im Projekt ankommt, ist etwas anderes.
Die Rechnung von der Aufgabe zum Projekt
Selbst unter günstigen Annahmen landet die Projektwirkung weit unter der zitierten Zahl - weil sich die drei Faktoren multiplizieren.
Kontextreife beschreibt zwei Dinge. Erstens, welcher Anteil des Wissens, das eine Änderung braucht, für die AI abrufbar ist - in Code, Tests, Dokumentation und Regeln statt nur in den Köpfen der Entwickler. Zweitens, wie gut dieser Kontext ist: wie umfangreich, wie stringent und einheitlich, wie wenig widersprüchlich. Dazu gehört auch klassische Codequalität: Lesbarkeit, klare Struktur, Tests. Erste Studien zeigen, dass KI auf gesundem Code seltener Funktionalität kaputt macht (Borg et al., 2026, Preprint, Autoren mit Herstellerbezug).
Tätigkeitsanteil beschreibt, dass Entwicklung nicht nur aus Coding besteht. Dazu kommen Zeremonien und Meetings, Abstimmungen, Ad-hoc-Aufgaben, Vor- und Nachbereitung, Recherche. Ein Hebel auf das Coding wirkt nur auf diesen Anteil. Meetings sind dabei geblockte Zeit: In ihnen wird nicht programmiert. AI hilft bei Meetings vor allem in der Vor- und Nachbereitung - und die fällt bei vielen eher spontanen Terminen ohnehin knapp aus. In Feldstudien liegt die reine Coding-Zeit von Entwicklern oft nur bei 11 bis 21% (Meyer et al., 2017; Meyer et al., 2019; Kumar et al., 2025). Die 70% im Beispiel sind deshalb bewusst sehr günstig gewählt. Mehr dazu, welcher Teil der Woche überhaupt erreichbar ist: 30 Minuten bleiben 30 Minuten.
Was die Studien je Faktor hergeben
Das Beispiel oben ist eine Illustration. Für jeden der drei Faktoren gibt es aber Studien, aus denen sich eine übliche Spanne ableiten lässt:
Reines Coding 11 bis 21%; mit Code verstehen, Testen und Debuggen deutlich mehr - allein das Verstehen von Programmen macht in einer Studie 58% der Zeit aus (Xia et al., 2018)
Experimente 2023 bis 2025 messen 21 bis 56% Zeitersparnis (Paradis et al., 2024; Peng et al., 2023).
Nur indirekt messbar: Agenten lösen in kommerziellen Repositories 15 bis 18% der Aufgaben, auf gängigen Benchmarks über 70% (SWE-Bench Pro, 2025)
Das Ergebnis: Ein typischer Bruttoeffekt liegt eher im einstelligen Bereich. Die 36% aus dem Beispiel liegen sogar über dem günstigsten Szenario, das sich mit Studien belegen lässt. Am schwächsten belegt ist die Kontextreife - und genau dort liegt der größte Hebel.
Jede Studie durch dieselbe Rechnung
Studien zu AI in der Entwicklung lassen sich schlecht direkt vergleichen, weil sie auf verschiedenen Ebenen messen. Die Formel hilft beim Normalisieren - wenn man prüft, welche Faktoren eine Studie schon enthält:
- Laborexperiment: eine isolierte Aufgabe ohne gewachsene Codebasis. Gemessen wird nur der Effizienzhebel. Tätigkeitsanteil und Kontextreife kommen als Spanne dazu.
- Feldexperiment: echte Aufgaben in echten Codebasen. Hebel und Kontext stecken schon im Ergebnis. Es fehlt nur der Tätigkeitsanteil.
- Messung auf Organisationsebene: Das ist bereits der Projekteffekt. Hier wird nichts mehr gerechnet.
Nach der Normalisierung landen die Feldexperimente bei rund 5 bis 14% - nah am typischen Wert aus den Faktor-Spannen. Laborwerte streuen breiter, weil zwei unbekannte Faktoren dazukommen: Eine einzelne Laborzahl sagt über ein Projekt wenig aus. Eine Auswertung von Git-Historien in über 100.000 Entwicklerkonten kommt direkt auf Organisationsebene auf netto 15 bis 20% mehr Output, mit deutlich kleineren Gewinnen in komplexem Bestandscode (Denisov-Blanch, 2025, Vortrag, nicht begutachtet).
Bei Cui et al. haben wir 26% mehr abgeschlossene Aufgaben in rund 21% Zeitersparnis umgerechnet.
Ein Sonderfall: Experten im eigenen Code
Eine Studie führen wir bewusst nicht in der Rechnung. Anfang 2025 bearbeiteten 16 erfahrene Open-Source-Entwickler 246 echte Aufgaben in ihren eigenen, großen Repositories - per Zufall mit oder ohne AI. Mit AI brauchten sie 19% länger. Hinterher schätzten sie sich trotzdem 20% schneller ein (METR, 2025).
Für den Effizienzhebel taugt das nicht: Die Teilnehmenden kannten ihren Code sehr gut, waren ohne AI schon schnell, und die Werkzeuge sind von Anfang 2025. Als Hinweis taugt es sehr wohl - gefühlter und gemessener Effekt können weit auseinanderliegen.
Von brutto zu netto
Der Bruttoeffekt ist noch nicht die gewonnene Zeit. Davon gehen zwei Arten von Aufwand ab, die ohne AI nicht anfallen:
- Mehraufwand für Qualität und Prüfung: Entwürfe der AI müssen gelesen, getestet und freigegeben werden. Mehr Output bedeutet mehr Review.
- Weiterentwicklung und Pflege der agentischen Systeme: an die eigenen Prozesse anpassen, ihr Verhalten verfeinern, Updates und Migrationen auf neue Modelle und Werkzeuge, den Kontext pflegen.
Dazu kommen Tool- und Modellkosten, der Aufbau der Engineering-Umgebung und Schulung. Der Gewinn auf der Aufgabe ist real. Was netto im Projekt ankommt, hängt vom Arbeitspaket, vom Anteil am Ganzen und von diesem laufenden Aufwand ab.
Ein eigenes Praxisexperiment zeigt dieselbe Spannweite: Bei 14 Tickets, mit teils geschätztem Aufwand, sank der Aufwand bei kleinen Tickets um rund 93%, beim großen, komplexen nur um rund 18% (zum Praxisexperiment).
Und die gewonnene Zeit ist mehr als Kürzungspotenzial. In unseren Projekten fließt sie in das, wofür vorher keine Zeit war: Weiterentwicklung, Qualität, Themen, die im Backlog liegen geblieben sind. Wer den Effekt nur in eingesparten Stunden zählt, misst die falsche Größe - entscheidend ist, was das Team mit der frei gewordenen Zeit erreicht. Deshalb empfehlen wir, die gewonnene Zeit in weitere Themen zu stecken - das ist in aller Regel die bessere Investition. Wer den Gewinn trotzdem lieber als kleineres Team nutzt, kann das: Als Dienstleister setzen wir unsere Leute dann in anderen Projekten ein, wo ihre Erfahrung ohnehin gefragt ist.
Was die Forschung sagt
Wir stützen uns nicht nur auf eigene Zahlen. Fünf Befunde aus aktuellen Studien - inklusive Gegenbefund:
| Befund | Quelle | Art der Evidenz |
|---|---|---|
| 22,7% der von AI eingeführten Probleme sind in der aktuellen Version noch vorhanden - über 302.600 verifizierte AI-Commits in 6.299 Repositories | Liu et al., arXiv 2603.28592 (2026) | Beobachtungsstudie, statische Analyse |
| Refactoring sank von 21% auf 3,8% der geänderten Zeilen; duplizierte Blöcke +81% | GitClear (2026) | Langzeit-Repository-Telemetrie |
| Output etwa verdoppelt - Review-Last ebenfalls etwa verdoppelt | Denisov-Blanch et al., arXiv 2607.01904 (2026) | Längsschnitt, ein Unternehmen, Preprint |
| 44% der getesteten Code-Generierungsaufgaben enthielten eine erkennbare Schwachstelle; Quote stagniert | Veracode (2026) | Kontrollierter Security-Benchmark |
| Spezifikationen gingen mit leicht mehr Fehlern und mehr Nacharbeit einher - laut Autoren ein Selektionseffekt | Hill, SSRN (2026) | Beobachtungsstudie, bewusst als Gegenbefund |
Die Brownfield-Realität
Für eine gewöhnliche Änderung in einem System, das seit Jahren läuft, braucht ein Agent:
- die Anforderung in prüfbarer Form - oft gibt es nur ein Ticket, etwas Prosa und ein Gespräch,
- die Regeln, die die Änderung einhalten muss - oft nur in den Köpfen langjähriger Teammitglieder,
- einen Weg, das System zu bauen und zu starten - oft ein Setup, das von Hand am Laufen gehalten wird,
- Tests, die zeigen, dass die Änderung funktioniert - oft nur dort, wo Testen einfach war.
Kontextreife ist keine feste Obergrenze, sondern ein Investitionspfad. Tests, Dokumentation, ein reproduzierbarer Build und explizite Regeln sind der größte einzelne Hebel.
Mensch und Maschine: wer macht was?
Tätigkeitsanteil und Kontextreife waren schon vor AI die Grenzen eines Projekts. Neu ist eigentlich nur der Effizienzhebel. Naheliegend wäre deshalb, die Rechnung zweimal aufzustellen - einmal mit menschlicher, einmal mit maschineller Effizienz - und zu vergleichen. Dann würden sich Anteil und Kontext herauskürzen.
Das tun sie aber nicht, denn beide Faktoren sind für Mensch und Maschine verschieden:
- Kontext: Menschen tragen implizites Wissen - warum etwas so gebaut ist, wer was entschieden hat, was der Kunde eigentlich meint. Eine AI sieht nur, was aufgeschrieben ist. Je mehr davon nur in Köpfen steckt, desto kleiner der Vorsprung der Maschine.
- Anteil: Nicht jede Tätigkeit liegt beiden gleich. Innerhalb dessen, was eine AI gut kann, waren Berater mit AI 25,1% schneller und lieferten über 40% bessere Qualität. Bei einer Aufgabe knapp außerhalb dieser Grenze lagen sie um 19 Prozentpunkte seltener richtig als ohne AI (Dell’Acqua et al., 2023). Die Grenze verläuft dabei nicht gerade, sondern zackig - von außen ist ihr Verlauf schwer zu erkennen.
Mehr AI ist deshalb nicht automatisch besser. Eine Metaanalyse über 106 Experimente zeigt: Im Schnitt schneiden Mensch und AI zusammen schlechter ab als der Bessere von beiden allein. Gewinne gibt es eher bei Aufgaben, in denen etwas erzeugt wird, und dort, wo der Mensch allein schon stark ist. Verluste gibt es eher bei Entscheidungsaufgaben (Vaccaro et al., 2024). Auch Vertrauen hat eine Kehrseite: Mit AI-Assistent schrieben Entwickler in einer Studie unsichereren Code - und hielten ihn häufiger für sicher (Perry et al., 2023).
Zwei verbreitete Annahmen tragen die Studien nicht. Kreativität ist kein reiner Vorsprung des Menschen: Bei erzeugenden Aufgaben hilft die Kombination eher. Und eine AI wechselt zwar ohne Anlaufzeit den Kontext, verarbeitet langen Kontext aber nicht verlustfrei - Information in der Mitte langer Eingaben wird schlechter genutzt (Liu et al., 2024).
Für die Rechnung heißt das: Der Gewinn entsteht nicht dadurch, dass die AI alles ein bisschen schneller macht. Er entsteht durch eine bewusste Arbeitsteilung - die Maschine erzeugt und sucht, der Mensch entscheidet und prüft. Und jedes Stück Wissen, das aus den Köpfen in Code, Tests und Regeln wandert, verschiebt die Grenze dessen, was die Maschine übernehmen kann.
Wohin die Entwicklung geht
Einzelne Studien sind Momentaufnahmen. Aussagekräftiger sind Reihen, die jedes Jahr mit derselben Methode messen. Sie zeigen eine Schere: Was die Technik kann, wächst schnell. Was im Projekt ankommt, wächst bisher kaum mit.
Die Werte stammen aus der Messung der Aufgabenlänge (METR, 2025; METR, 2026), aus der Preisentwicklung (Epoch AI, 2026), aus der Entwicklerumfrage (Stack Overflow, 2025), aus der amtlichen Statistik (Destatis, 2025; EU: 8% auf 20%, Eurostat, 2025) und aus einer Langzeitanalyse von Repositories (GitClear, 2026, Analyseanbieter, kein Kausalnachweis).
Was heute belastbar ist: Fähigkeit und Preis entwickeln sich exponentiell, Nutzung und Verbreitung verdoppeln sich in wenigen Jahren. Gleichzeitig sinken Zustimmung und Vertrauen, und der Code wird seltener aufgeräumt. Der gemessene Gewinn im Projekt bleibt in einem engen Band.
| Perspektive für 1 bis 3 Jahre | Sicherheit | Grundlage |
|---|---|---|
| Heutige Spitzenleistung kostet in etwa einem Jahr einen Bruchteil. Kosten werden selten das Argument gegen AI sein | hoch | stabiler Preistrend über drei Jahre |
| Agenten übernehmen längere, zusammenhängende Aufgaben - von Stunden hin zu Tagen | mittel | Verlängerung des bisherigen Trends; der Messaufbau stößt oberhalb von 16 Stunden an seine Grenze |
| Damit wächst der Tätigkeitsanteil, auf den der Hebel wirkt | mittel | unsere Ableitung aus Trend und Formel |
| Der Engpass wandert zu Kontextreife und Prüfung: Wenn mehr Code entsteht, dem weniger vertraut wird, werden Review und Qualitätssicherung knapp | mittel | unsere Ableitung aus der Schere |
| Eine Prozentzahl für den Projekteffekt in drei Jahren | nicht seriös | keine Reihe misst den Projekteffekt über die Zeit |
Für die Rechnung heißt das: Der Effizienzhebel wird weiter wachsen - er war aber schon heute nicht der begrenzende Faktor. Wer Kontextreife und Prüfung jetzt aufbaut, nimmt den Fortschritt der nächsten Modelle mit. Wer das nicht tut, kauft schnellere Werkzeuge für denselben Engpass.
Was das für den Einkauf heißt
Belastbarer als eine Prozentzahl ist eine Spanne mit genannten Bedingungen. Zwei faire Wege: den AI-Effekt als Spanne vereinbaren, mit dem klassischen Angebot als Rückfallebene - oder gemeinsam starten, messen und nachjustieren.
Dazu kommen zwei Modelle, bei denen das Risiko bei uns liegt: ein Festpreis inklusive AI - geht es schneller, profitieren wir, dauert es länger, wird es für Sie nicht teurer. Oder eine Beteiligung am Business Case: Wir rechnen gemeinsam, ab wann sich das Vorhaben für Sie lohnt, setzen es um und erhalten einen vereinbarten Anteil an der Ersparnis, wenn das Ergebnis stimmt. Der Preis richtet sich dann am Nutzen aus, nicht an Stunden.
Für Beratung, Workshops und das Kennenlernen am Anfang arbeiten wir auch nach Aufwand oder mit kleinen Festpreisen. Wir nennen den Budgetrahmen, in dem wir voraussichtlich landen - so bleibt das Vorhaben flexibel, solange sich Ziel und Umfang noch klären, ohne dass vorher ein großes Budget freigegeben werden muss. Alle Modelle im Überblick: Nach Aufwand, Festpreis oder Sprints?
Messen Sie dabei nicht nur, was schneller geht, sondern auch, was dadurch zusätzlich möglich wird: abgearbeitete Rückstände, mehr Tests, Zeit für Verbesserungen. Dort zeigt sich der Wert am deutlichsten.
